Stanford e Berkeley ensinam LLM a ler seletivo: 11,3x mais rápido, no melhor cenário
TokenGate poda tokens irrelevantes antes das camadas pesadas e vem com código aberto no Apache-2.0.
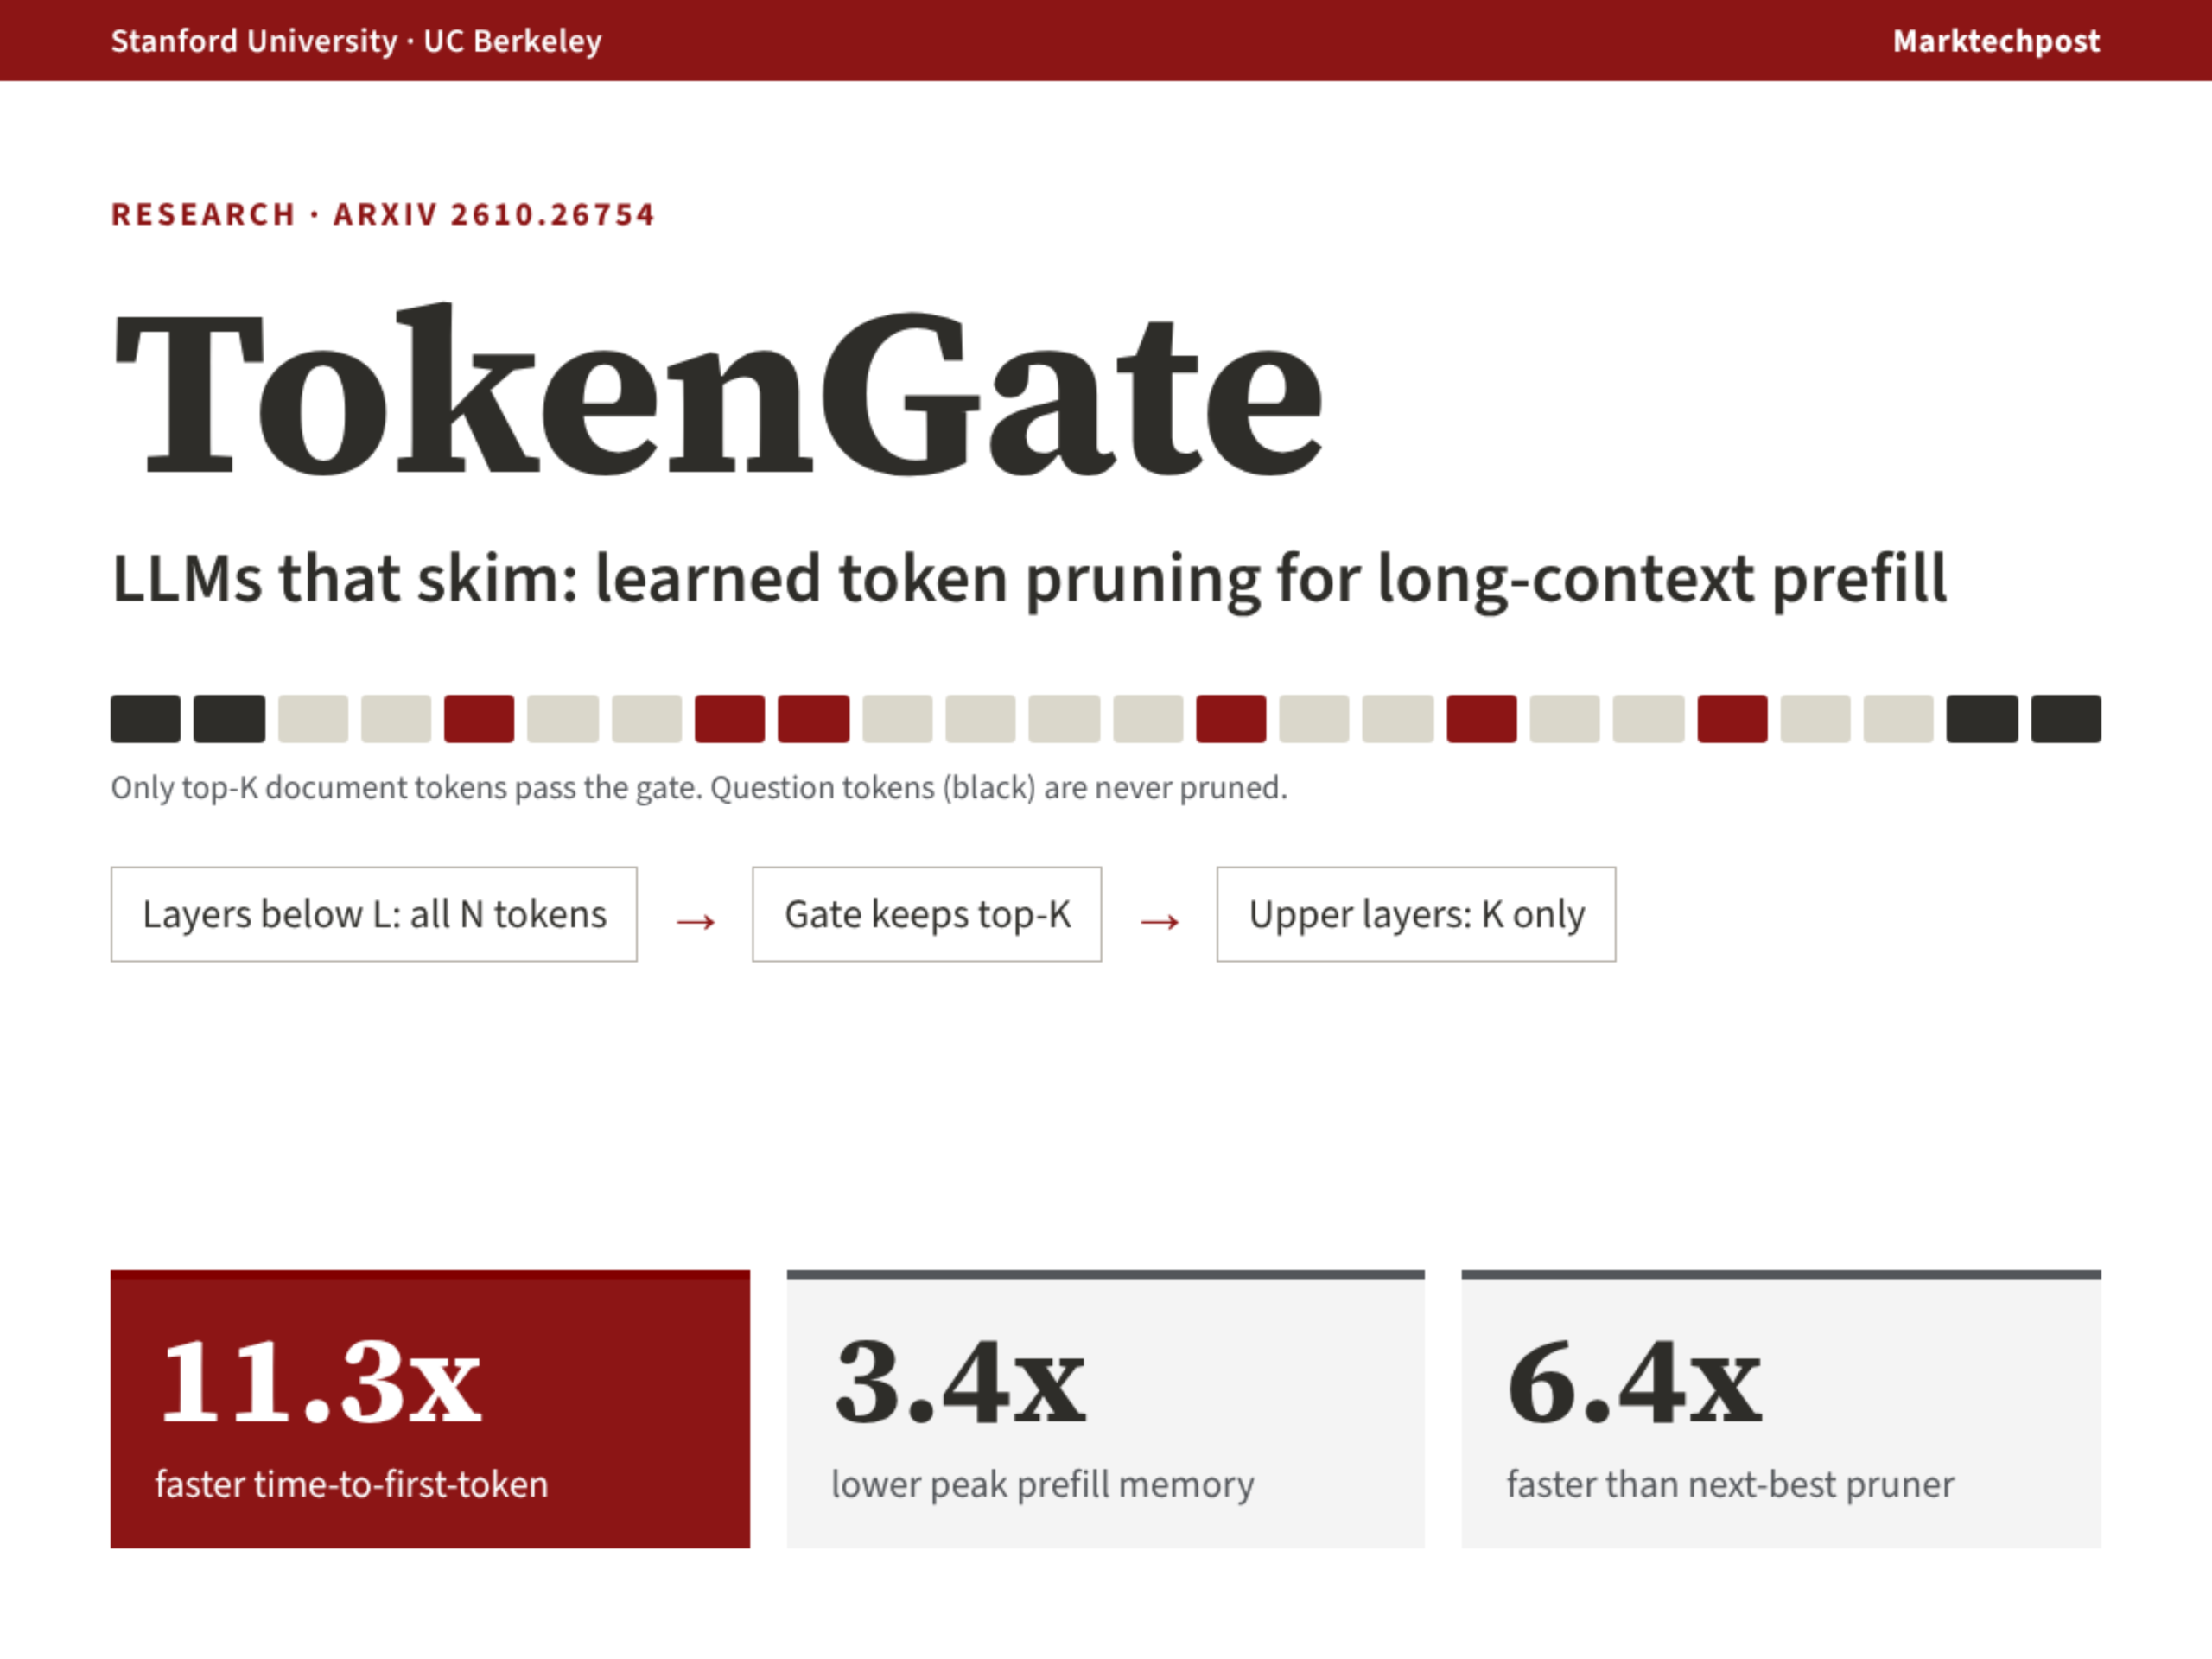
Pesquisadores da Stanford e da UC Berkeley apresentaram o TokenGate, um módulo plug-and-play que aprende a descartar tokens de contexto irrelevantes antes que camadas superiores do modelo os processem. Em testes com Qwen3-1.7B, o método reduziu o tempo até o primeiro token entre 1,4x e 11,3x e a memória de pico entre 1,5x e 3,4x, sem perda de precisão.
O pior caso registrado foi 1,4x de aceleração, longe do 11,3x da manchete, mas já o suficiente para encurtar esperas em contextos de até 128 mil tokens. Código e pesos estão no GitHub sob licença Apache-2.0, e os benchmarks enfrentaram seis métodos concorrentes nos mesmos modelos base.