IA transcreve 4min de áudio em 0,32 segundos, mas troca nome e exige revisão
Modelo japonês open source bate a Gemini 3.5 em precisão e ainda é o mais barato na mesma faixa.
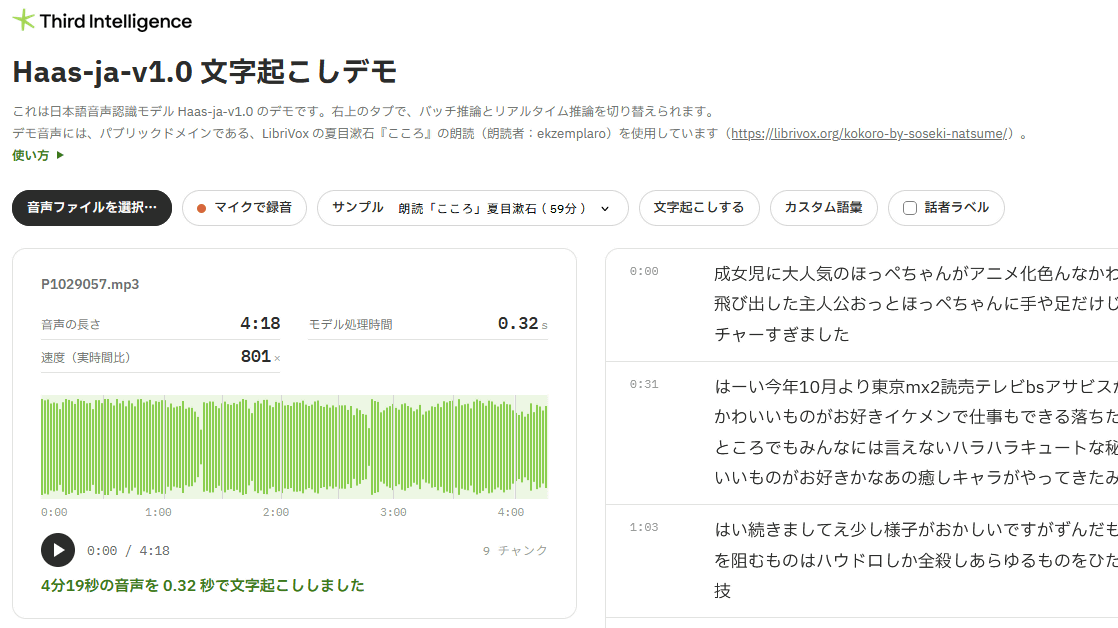
A japonesa Third Intelligence soltou o Haas-ja-v1.0, modelo de reconhecimento de voz focado em japonês, com 615,8 milhões de parâmetros. Entre os modelos avaliados, foi o de maior precisão no peso aberto, à frente da Gemini 3.5 transcribe, e o de menor custo na mesma faixa de qualidade.
Num teste, uma faixa de 4min19s de áudio foi transcrita em 0,32 segundos. A pegadinha: erros como trocar um nome por outro parecido, ou seja, revisão humana continua obrigatória. Pesos no Hugging Face e código no GitHub, com licença Apache 2.0.